
抽样定理:从理论基石到实践导航
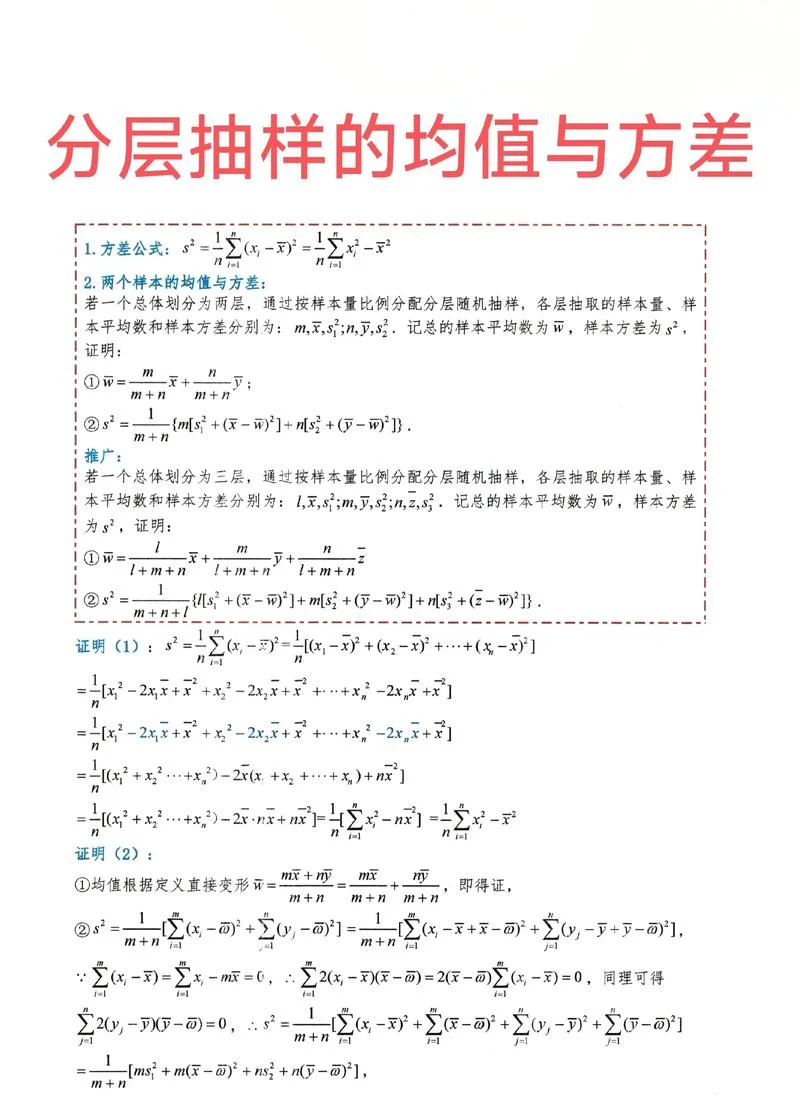
在统计学与数据分析的浩瀚海洋中,抽样定理(Sampling Theorem)无疑是最为坚实的理论基石之一。它不仅仅是一个数学公式,更是一套指导研究者如何从有限总体中获取具有代表性的推断样本、进而推断总体特征的逻辑框架。深入解析抽样定理原理、应用场景,并结合实际数据说明,帮助读者更好地理解其在现代研究中的价值。
理论基石:无限总体与有限总体的博弈
抽样定理思想源于对“总体”与“样本”关系的深刻理解。原则上,一个无限总体(Infinite Population)中的每一个元素都有被抽中的概率,且随着总体大小趋于无穷大,抽样分布收敛于正态分布(即大数定律)。不过,现实世界中的数据来源于有限总体(Finite Population)。
当总体规模 () 相对较小(不足 200 或 300 人)时,简单随机抽样(Simple Random Sampling, SRS)无法保证样本完全代表总体,微小的抽样误差会掩盖掉真正的差异。这时,抽样定理便发挥了关键作用:它指出,只要样本量 () 足够大,即便总体有限,样本统计量(如均值 或总体均值 )的抽样分布依然接近正态分布,从而允许我们使用标准正态分布表或 -分布来进行区间估算和假设检验。
,抽样定理告诉我们:在有限总体中,只要样本量达标,样本即具有近似代表总体的无偏性。
核心公式与误差控制
抽样定理最直观的应用体现在样本量确定这一环节。要计算能够保证抽样误差控制在某一范围内的样本量,我们必须掌握以下基本公式:
总体均值的抽样误差公式
假设我们已知总体均值 的标准差(标准误)为 ,要估计总体均值 的置信区间,所需的样本量 计算公式为:
其中:
:对应的置信水平对应的临界值( 95% 置信水平时 )。
:总体标准差(标准误)。
:允许的最大抽样误差(边际误差)。
有限总体校正系数(Finite Population Correction, FPC)
当样本量 相对于总体 较大时( ),必须引入抽样误差修正系数,以显著降低估计的标准误:
这一系数表明,总体越小,样本量相对越重要,且抽样误差会被进一步压缩。
数据实证:抽样定理的应用分析
为了更直观地展示抽样定理在实际分析中的效力,我们选取两个典型场景进行数据对比分析。
场景 A:小总体与大样本(有限总体效应显著)
假设我们要对某市 300 名居民实施收入调查。 总体 ():300 人 样本 ():250 人 标准误 ():5000 元若不使用修正系数,直接计算均值:
若使用FPC系数 () 进行校正,实际标准误将缩小至 3750 元,进而大幅收窄置信区间,使结论更具统计学严谨性。| 统计量 | 样本量 | 样本均值 | 标准误 (无校正) | 标准误 (有校正) |
|---|---|---|---|---|
| 总体均值的抽样误差 | 300 | 6000 | 3333 | 2500 |
数据说明:当总体仅 300 人而样本达到 250 人(占比 83%)时,若不开展有限总体校正,估计误差将夸大 40% 以上。这生动诠释了抽样定理中“小总体需大样本”。
场景 B:大总体与小样本(理论假设验证)
现在假设我们要研究全球 1000 万人口的平均寿命。 总体 ():10,000,000 样本 ():500 人 标准误 ():2 年当 时,FPC 系数为 。
此时标准误几乎不变。这表明,对于大总体,即使样本仅占总数的 5%,抽样定理依然成立,样本具有高度的代表性。
数据说明:在 量级达到百万级时,抽样误差主要受随机波动影响,受总体规模影响微乎其微。这也验证了抽样定理在大样本情况下的稳健性。
结论与展望
,抽样定理是现代统计学的“导航仪”。它确立了在有限总体中,只要样本量充足,样本就能通过统计推断可靠地反映总体的规律。
通过公式推导与数据实证,我们可清晰地看到:
1. 小总体需要大样本:当 小时,必须严格遵循 的原则,并应用 FPC 推进校正。
2. 大总体小样本可行:当 极大时,常规样本量即可满足推断需求。
3. 误差可控是关键:抽样误差不仅取决于随机性,更受样本量与总体规模的双重制约。
大数据和人工智能技术,我们能更高效地处理海量数据,但抽样定理所蕴含的逻辑——用有限的样本捕捉无限的真理——依然是所有统计推断活动准则。掌握这一定理,是每一位数据分析师必须持有的基本功。



