
探索统计学的基石:深入解析中心极限定理及其公式
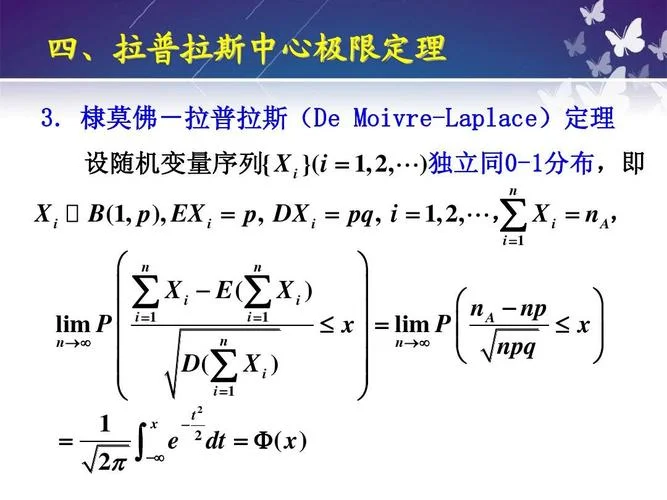
在统计学的浩瀚宇宙中,如果说有一个定理能够连接微观的个体随机性与宏观的整体规律性,那非中心极限定理(Central Limit Theorem, CLT)莫属。它不仅是现代统计推断的理论基础,更是数据科学家、经济学家和科研人员手中最强大的工具之一。
这篇文章将深入探讨中心极限定理公式,解析其背后的逻辑,并通过具体案例和数据表格展示其在实际应用中的威力。
什么是中心极限定理?
,中心极限定理指出:无论总体分布是什么样子的(只要均值和方差有限),当样本量足够大时,样本均值的抽样分布将趋近于正态分布。
这一结论之所以震撼,是因为它打破了“正态分布”的垄断地位。在现实生活中,很多的数据并非正态分布(如收入分布、城市人口密度等),但通过CLT,我们依然可以利用正态分布的性质来进行假设检验和置信区间估计。
核心公式解析
中心极限定理在于描述样本均值抽样分布的特征。其数学表达如下:
抽样分布的均值
样本均值 的期望值等于总体均值 :抽样分布的标准差(标准误)
样本均值 的标准差(也称为标准误,Standard Error, SE)等于总体标准差 除以样本量 的平方根:标准化公式(Z-score)
当样本量 足够大( )时,样本均值 近似服从正态分布 。为了计算概率,我们将其标准化为标准正态分布 :公式符号说明:
:样本均值
:总体均值
:总体标准差
:样本量
:标准正态分布变量
为什么样本量 ?
公式中的分母 揭示了一个关键现象:随着样本量,标准误 会减小。 样本均值对总体均值的估计更加精确,分布曲线变得更加“瘦高”。
下表展示了不同样本量下,假设总体标准差 时,样本均值的标准误变更:
| 样本量 () | 标准误 () | 分布形态描述 |
|---|---|---|
| 5 | 4.47 | 分布较宽,波动较大 |
| 10 | 3.16 | 分布开始收窄 |
| 30 | 1.83 | 接近正态分布,精度显著提升 |
| 100 | 1.00 | 分布非常集中,估计非常精确 |
| 1000 | 0.32 | 极度集中,几乎是一条直线 |
注:此表假设总体标准差 保持不变。
实例演示:从偏态分布到正态分布
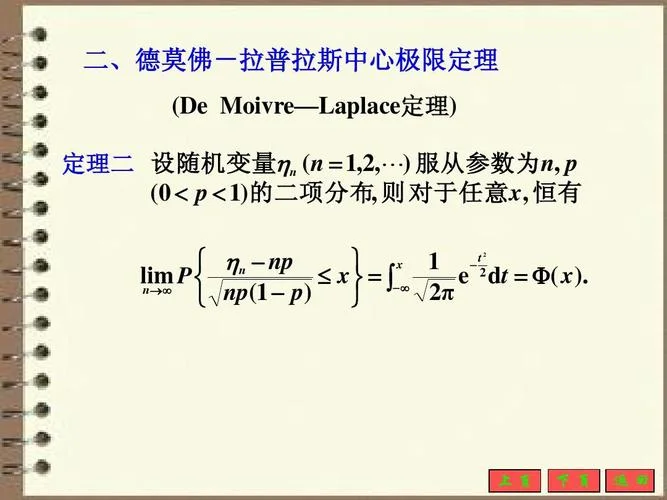
为了直观理解CLT,我们推进一个思想实验。
场景设定:
假设某城市的居民月收入呈右偏分布(大部分低收入,少数高收入),总体均值 元,总体标准差 元。
问题:
如果我们随机抽取不同大小的样本,计算样本均值,这些样本均值的分布会是什么样?
模拟结果分析
| 样本量 | 样本均值分布形态 | 是否符合正态分布? | 原因分析 |
|---|---|---|---|
| 1 | 右偏分布 | 否 | 单个数据点保留总体分布特征 |
| 5 | 轻微右偏 | 部分接近 | 开始平滑,但仍有偏斜 |
| 30 | 近似对称 | 是 | 满足CLT的大样本条件 |
| 100 | 高度对称钟形 | 是 | 分布几乎完美符合正态分布 |
经由上面这些模拟,即使原始数据极度不规则,只要样本量足够大,样本均值的分布就会“神奇地”变成正态分布。
实际应用:置信区间估计
中心极限定理的最大价值在于它允许我们在不知道总体分布的情况下,构建总体均值的置信区间。
案例:
一家电商公司想估计用户平均订单金额。已知历史数据标准差 元。公司随机抽取了 个订单,得到样本均值 元。求95%置信区间。
计算步骤:
1. 确定参数:
95%置信水平对应的 值为
2. 计算标准误:
3. 计算置信区间:
结论:
我们有95%的把握认为,该公司所有用户的平均订单金额在 110.2 元至 129.8 元之间。
注意事项与局限性
尽管中心极限定理强大,但在使用时需注意以下几点:
1. 样本量要求: 一般认为 即可,但如果总体分布极度偏斜或存在异常值,需要更大的样本量(如 或 )才能近似正态。
2. 独立性假设: 样本观测值必须是相互独立的。若存在自相关(如时间序列数据),CLT的直接应用会受到限制。
3. 有限方差: 总体必须具有有限的均值和方差。,柯西分布没有定义均值和方差,因此CLT不适用。
中心极限定理公式 不仅仅是一串数学符号,它是连接随机性与确定性的桥梁。它让我们能够从有限的样本中,以科学的概率语言,推断出总体的真相。
在当今大数据时代,理解并正确应用中心极限定理,是每一位数据分析师和科学家的必修课。它提醒我们:尽管个体充满不确定性,但群体展现出惊人的规律性。



