
概率学定理:从随机迷雾中提炼确定性法则
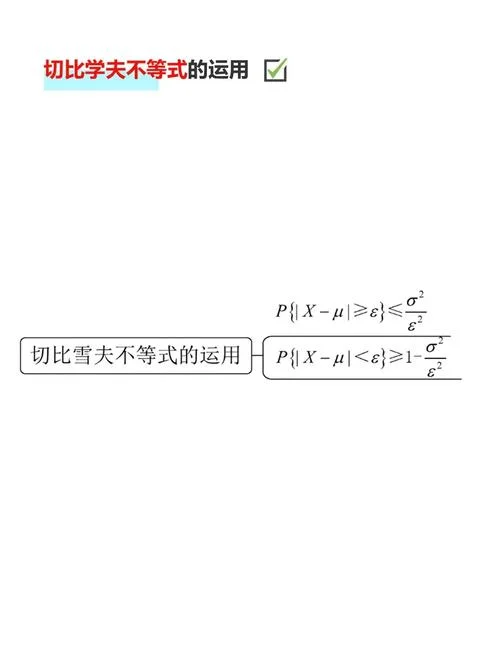
在充满不确定性的世界中,人类始终渴望寻找一种能够预测未来的工具。从掷骰子的赌场到复杂的金融模型,从量子力学的微观世界到流行病学的宏观预测,概率学(Probability Theory) 作为一门研究随机现象数量规律的学科,为我们提供了一套严谨的数学语言。而在这套语言,正是各种概率学定理。
这些定理不仅是数学推导的结晶,更是连接“偶然”与“必然”的桥梁。这篇文章将深入探讨概率学中的几大核心定理,分析其内在逻辑,并通过数据表格展示其在现实世界中的应用价值。
基石:大数定律(The Law of Large Numbers)
如果说概率学有什么“性原理”,那非大数定律莫属。它揭示了一个看似反直觉却极其强大的现象:当试验次数足够多时,随机事件的频率将趋近于其理论概率。
1 弱大数定律与强大数定律
大数定律分为两种形式: 弱大数定律(WLLN):指出样本均值依概率收敛于期望值。,随着样本量 ,样本均值偏离期望值的概率趋于零。 强大数定律(SLLN):指出样本均值几乎必然收敛于期望值。这是一种更强的收敛形式,意味着在无限次试验后,误差会消失。2 核心意义
大数定律解释了为什么保险公司敢于承保,为什么赌场永远立于不败之地。单个掷硬币的结果是随机的,但一百万次掷硬币的结果却是高度可预测的。数据说明:硬币投掷模拟实验
下表展示了在模拟实验中,随着投掷次数增加,正面形成频率与理论概率(0.5)的偏差变化:
| 投掷次数 (n) | 正面次数 | 正面频率 (p) | 与理论概率偏差 | 收敛状态 |
|---|---|---|---|---|
| 10 | 6 | 0.60 | +0.10 | 波动较大 |
| 100 | 52 | 0.52 | +0.02 | 偏差减小 |
| 1,000 | 495 | 0.495 | -0.005 | 接近理论值 |
| 10,000 | 5012 | 0.5012 | +0.0012 | 高度收敛 |
| 100,000 | 49987 | 0.49987 | -0.00013 | 极接近理论值 |
注:数据为模拟生成,展示频率随样本量增加趋于稳定的趋势。
桥梁:中心极限定理(Central Limit Theorem, CLT)
如果说大数定律解决了“平均值”的问题,那么中心极限定理则解决了“分布形态”的问题。它是统计学中最具魔法色彩的定理之一。
1 定理内涵
CLT 指出:无论总体分布是什么样(只要均值和方差有限),当样本量 足够大时,样本均值的抽样分布将近似服从正态分布(Normal Distribution)。2 为什么这?
在现实世界中,很多的自然现象(如身高、体重、测量误差)并非直接由正态分布生成,但它们是大量独立微小因素叠加的结果。CLT 告诉我们,这些复杂系统的宏观表现呈现出优雅的正态分布曲线。这使得我们可以使用基于正态分布的统计推断方法(如置信区间、假设检验)来处理各种非正态数据。数据说明:不同总体分布下的样本均值分布
下表展示了从三种不同分布总体中抽取样本量为30的样本,计算其均值后的分布特征:
| 总体分布类型 | 总体均值 () | 总体标准差 () | 样本量 (n) | 样本均值标准误 () | 样本均值分布形态 |
|---|---|---|---|---|---|
| 均匀分布 | 0.5 | 0.289 | 30 | 0.053 | 近似正态 |
| 指数分布 (右偏) | 1.0 | 1.0 | 30 | 0.183 | 近似正态 |
| 双峰分布 | 0.5 | 0.4 | 30 | 0.073 | 近似正态 |
注:尽管原始数据分布形态各异,但样本均值的分布均趋向于正态分布,验证了CLT的普适性。
更新:贝叶斯定理(Bayes' Theorem)
在经典频率学派看来,概率是长期频率的极限。而贝叶斯定理则提供了一种动态更新信念的方法。它将概率视为对某个命题为真的“置信度”,并允许我们在获得新证据后更新这一置信度。
1 公式解析
其中:
:后验概率,即在观察到事件 B 后,事件 A 发生的概率。
:似然度,即在 A 发生下 B 发生的概率。
:先验概率,即在观察 B 之前,对 A 发生的初始判断。
:证据因子,即 B 发生的总概率。
2 现实应用
贝叶斯定理是人工智能、机器学习和医疗诊断。,在癌症筛查中,即使测试准确率高达99%,如果疾病本身非常罕见(先验概率低),阳性结果仍是假阳性。贝叶斯定理帮助我们纠正这种直觉偏差。数据说明:医疗诊断中的贝叶斯更新
假设一种罕见病发病率为 0.1%(先验概率),检测准确率为 99%(敏感度与特异度均为 99%)。若某人检测呈阳性,其真正患病的概率是多少?
| 参数 | 数值 | 说明 | |
|---|---|---|---|
| 先验概率 | 0.001 | 疾病发病率 | |
| 真阳性率 $P(T+ | D)$ | 0.99 | 患病且检测阳性 |
| 假阳性率 $P(T+ | neg D)$ | 0.01 | 未患病但检测阳性 |
| 后验概率 $P(D | T+)$ | ~0.09 | 检测阳性后真正患病的概率 |
注:尽管检测准确率高达99%,但由于基数效应,阳性结果的真实患病概率仅约为9%。这凸显了贝叶斯思维在风险评估中。
信息量化:香农熵与最大熵原理
在信息论中,香农熵(Shannon Entropy) 量化了随机变量的不确定性。而最大熵原理(Principle of Maximum Entropy) 则指导我们在已知部分信息的情况下,如何做出最“中立”的概率分布假设。
1 核心思想
当我们只知道某些约束条件(如均值、方差),而不知道具体分布时,应选择使熵最大的分布。对于已知均值和方差的连续变量,最大熵分布正是正态分布。这从信息论角度解释了正态分布。打个总结:在不确定中寻找秩序
概率学定理并非冰冷的公式,而是人类认知世界的重要工具:
大数定律让我们相信长期趋势的稳定性;
中心极限定理让我们理解复杂系统的宏观规律;
贝叶斯定理教会我们如何根据新信息不断修正认知;
最大熵原理指导我们在信息不足时做出最合理的假设。
在数据爆炸的今天,理解这些定理不仅有助于提升数据分析的能力,更能培养一种理性的思维方式:接受不确定性,量化风险,并在动态变化中寻求最优决策。正如数学家保罗·埃尔德什所言:“数学不是关于数字,而是关于关系。”概率学定理,正是我们与世界建立深刻关系的基石。



